LangChain教程
知止自律打卡-微信小程序APP
一款微信自律打卡小程序,支持自定义打卡项目、习惯记录、项目日记、专注计时与数据统计。自律打卡、学习打卡、读书打卡、健身打卡、运动打卡、减肥打卡、戒色打卡、养生打卡、戒烟、戒酒、戒熬夜等多种场景。万能打卡模板自由创建。可自定义每日打卡目标,记录习惯连续天数,可视化追踪成长进度。
了解产品详情 →
微信搜索「知止自律打卡」
1 简介
LangChain 是一个用于构建基于大语言模型(LLM)应用的强大框架,它将语言模型与各种外部数据源(如向量数据库、API、搜索引擎等)结合,适合构建聊天机器人、文档问答、智能体系统(Agent)、工具调用、链式推理等AI应用。
1.1 LangChain 核心概念简介
| 模块 | 说明 |
|---|---|
| LLM | 接入大预言模型,如OpenA、Aliyun、ChatGLM |
| Prompt | 构建提示词模板 |
| Chains | 多步链式调用,输出作为下一个步骤输入 |
| Tools | 第三方工具、如API、搜索引擎等 |
| Agents | 动态决策调用哪些工具 |
| Memory | 会话记忆模块 |
| Vectorstore | 向量数据库,如FAISS、Milvus,用于文档问答 |
| Loaders | 文档加载器,如PDF、网页、txt、CSV等 |
1.2 环境、依赖
Python版本:Python3.10
langchain==0.3.26
requests==2.32.3
2 LLM模块(语言模型接入)
LangChain 可通过自定义 LLM 类封装任意模型,比如通义千问API。
调用通义千问案例:
封装为类:util_ali_llm.py
"""
pip install langchain requests
langchain==0.3.26
"""

from langchain_core.language_models.llms import LLM
from typing import Optional, List
import requests

class QwenLLM(LLM):
    model: str = "qwen-turbo"
    api_key: str = "你的阿里API Key"

    def _call(self, prompt: str, stop: Optional[List[str]] = None) -> str:
        headers = {
            "Authorization": f"Bearer {self.api_key}",
            "Content-Type": "application/json"
        }
        json_data = {
            "model": self.model,
            "input": {"prompt": prompt},
            "parameters": {"result_format": "text"}
        }
        resp = requests.post(
            url="https://dashscope.aliyuncs.com/api/v1/services/aigc/text-generation/generation",
            headers=headers,
            json=json_data
        ).json()
        return resp["output"]["text"]

    @property
    def _llm_type(self) -> str:
        return "qwen"


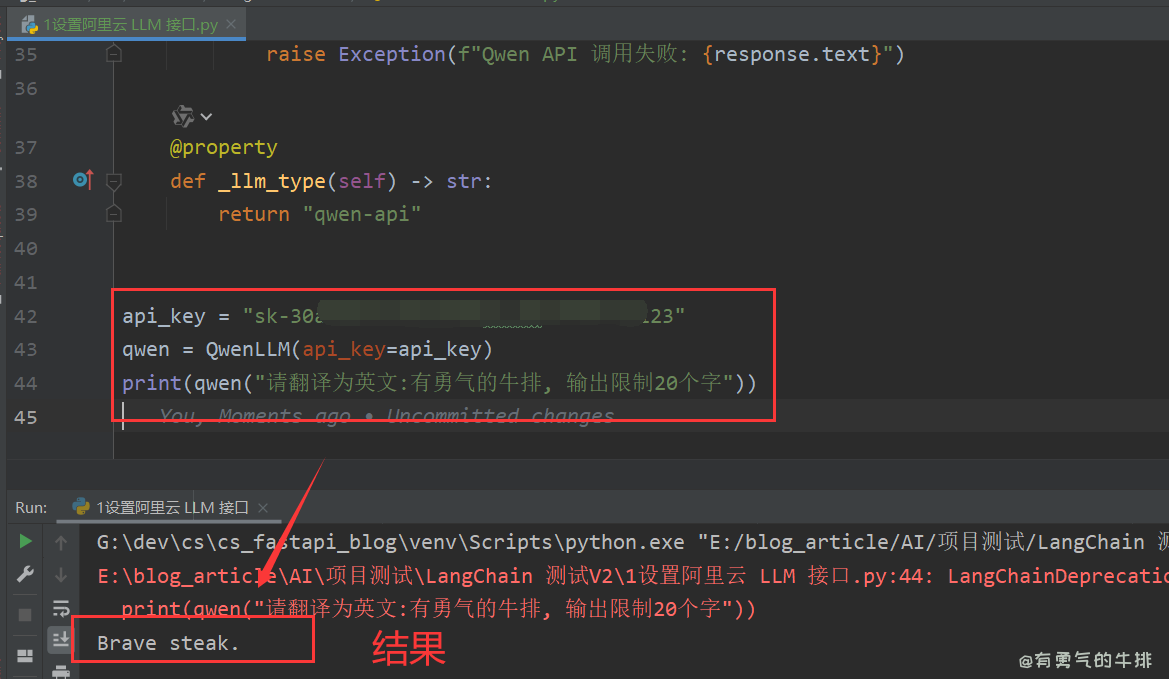
api_key = "sk-30a***123"
qwen = QwenLLM(api_key=api_key)
print(qwen("请翻译为英文:有勇气的牛排, 输出限制20个字"))
2 Prompt 模块
LangChain支持使用 PromptTemplate 定义复杂的提示词模板。
# -*- coding: utf-8 -*-
from langchain.prompts import PromptTemplate

template = """
    请将输入的文本转换成中文。
    输入:{user_input}
    """

prompt = PromptTemplate(template=template, input_variables=["user_input"])

user_input = "有勇气的牛排"
print(prompt.format_prompt(user_input=user_input))
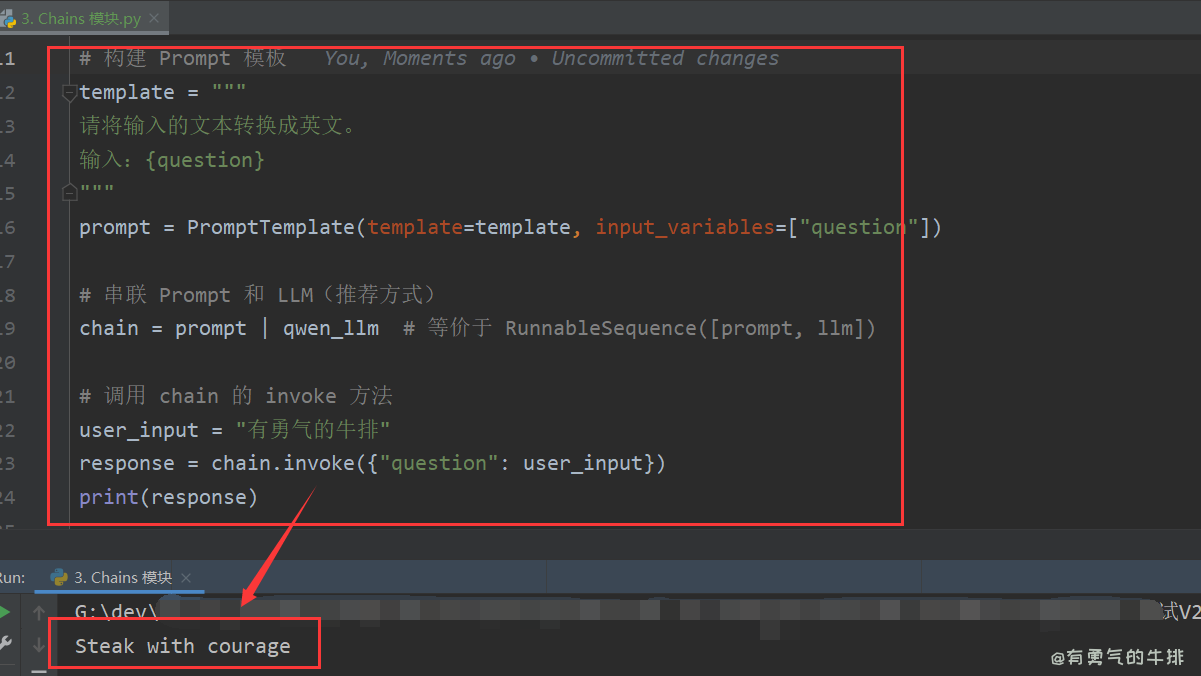
3 Chains 模块
使用链(Chain)使用多个模块串联。
# -*- coding: utf-8 -*-
from util_ali_llm import QwenLLM
from langchain.prompts import PromptTemplate
from langchain_core.runnables import RunnableSequence  # 新版链式执行推荐
# 或者 from langchain.schema.runnable import RunnableSequence 取决于你的版本

# 初始化 LLM
api_key = "sk-30a***123"
qwen_llm = QwenLLM(api_key=api_key)

# 构建 Prompt 模板
template = """
请将输入的文本转换成英文。
输入:{question}
"""
prompt = PromptTemplate(template=template, input_variables=["question"])

# 串联 Prompt 和 LLM(推荐方式)
chain = prompt | qwen_llm  # 等价于 RunnableSequence([prompt, llm])

# 调用 chain 的 invoke 方法
user_input = "有勇气的牛排"
response = chain.invoke({"question": user_input})
print(response)
4 Tools 模块
调用第三方接口,如天气、某些计算
多个 tool 工具统一封装成一个 agent-ready 的模块,例如自动识别用户输入、调用 IP 查询、天气、笑话、股票、翻译等,可无需关心内部结构。
4.1工具案例
4.1.1 计算圆的面积
calculate_area.py
from langchain.tools import tool

@tool
def calculate_area(radius: float) -> float:
    """计算圆的面积"""
    import math
    return round(math.pi * radius ** 2, 2)

print(calculate_area.invoke({"radius": 5}))
4.1.2 获取随机笑话
get_random_joke.py
import requests
from langchain.tools import tool

@tool
def get_random_joke() -> str:
    """获取一个随机笑话"""
    url = "https://official-joke-api.appspot.com/jokes/random"
    resp = requests.get(url).json()
    return f"{resp['setup']} —— {resp['punchline']}"

# 测试
print(get_random_joke.invoke({}))
4.2 在Agent中注册Tool
# -*- coding: utf-8 -*-
from langchain.agents import initialize_agent, AgentType, Tool
from tools.计算圆面积 import calculate_area
from tools.随机笑话 import get_random_joke
from tools.time_now import get_beijing_time
from util_ali_llm import QwenLLM

# 初始化 LLM
api_key = "sk-30a***123"
qwen_llm = QwenLLM(api_key=api_key)

tools = [
    Tool(name="Calculator", func=calculate_area.run, description="获取圆的面积"),
    Tool(name="Joke", func=get_random_joke.run, description="获取圆的面积", ),
    Tool(name="TimeTool", func=get_beijing_time.run, description="获取北京时间", ),
]

# 初始化Agent
agent = initialize_agent(
    tools, qwen_llm,
    agent=AgentType.ZERO_SHOT_REACT_DESCRIPTION,
    verbose=True,
    handle_parsing_errors=True  # 当 LLM 输出格式混乱时,自动 Retry 而不是直接报错。

)

# 调用示例
# print(agent.run("请告诉我现在的北京时间"))
# print(agent.run("请计算圆半径为5m的面积"))
# print("=============")
agent.run("给我讲个笑话")
# print(f"res: {res}")
4.3 工具统一注册
from tools.ip_location import get_ip_location
from tools.joke import get_joke
from tools.time_now import get_beijing_time
from tools.math_tools import calculate_circle_area

ALL_TOOLS = [
    get_ip_location,
    get_joke,
    get_beijing_time,
    calculate_circle_area
]
Agent 主程序(main.py)
from tools import ALL_TOOLS
from util_ali_llm import QwenLLM
from langchain.agents import initialize_agent, AgentType

if __name__ == "__main__":
    llm = QwenLLM()
    agent = initialize_agent(
        tools=ALL_TOOLS,
        llm=llm,
        agent=AgentType.ZERO_SHOT_REACT_DESCRIPTION,
        verbose=True
    )

    while True:
        query = input("你想问什么?(输入exit退出)\n> ")
        if query.lower() in {"exit", "quit"}:
            break
        result = agent.invoke(query)
        print("🤖", result)
5 Agent 模块
Agent 可根据输入智能决定调用哪些工具
from langchain.agents import initialize_agent, AgentType
from langchain.agents import Tool

tools = [
    Tool(name="AliWeather", func=ali_weather.run, description="获取指定城市的天气")
]

agent = initialize_agent(tools, llm, agent=AgentType.ZERO_SHOT_REACT_DESCRIPTION, verbose=True)

agent.run("请告诉我今天北京的天气")
6 记忆会话功能
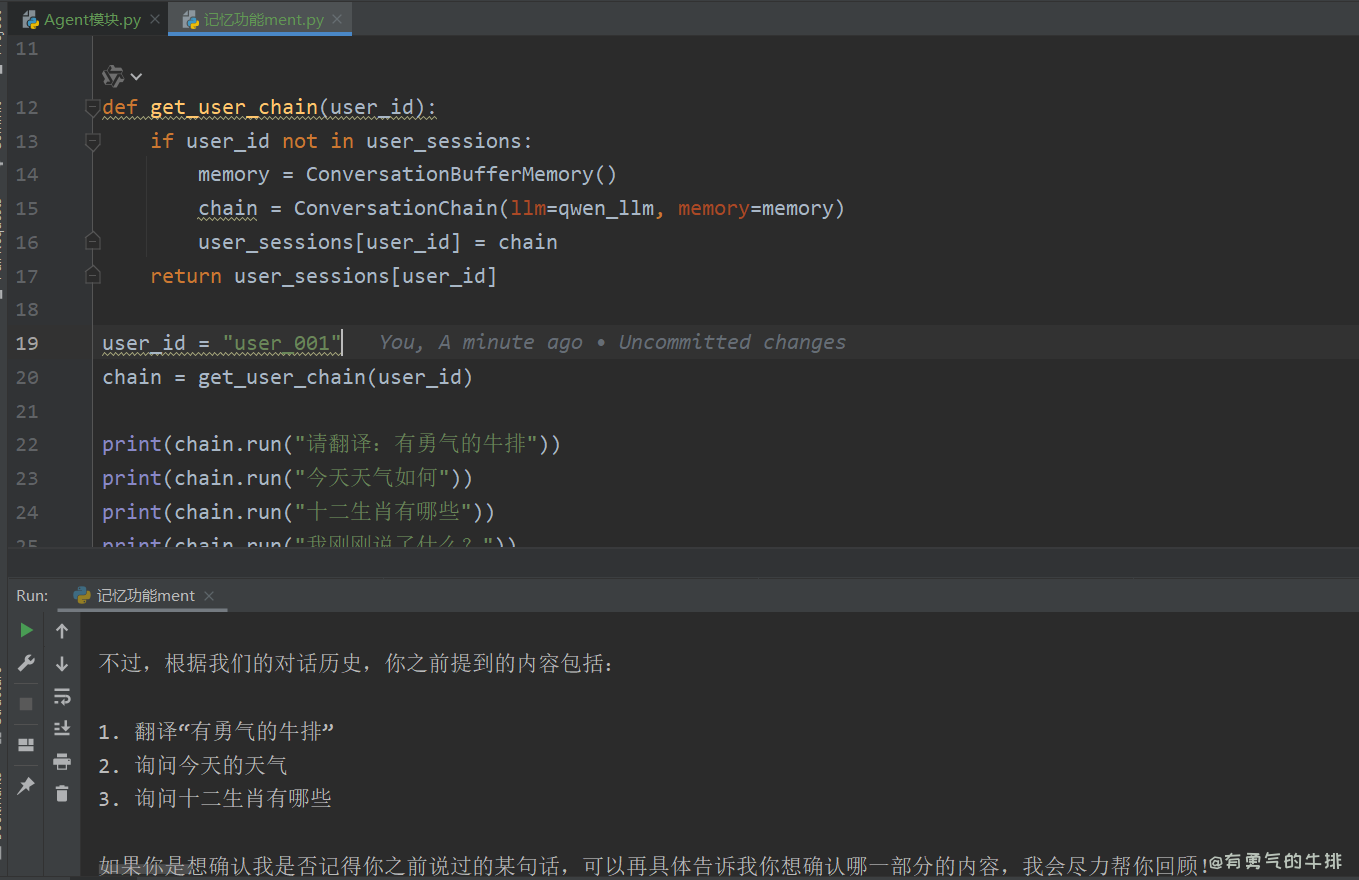
6.1 为每个用户单独创建一份 Memory 实例
每个用户维护独立的 ConversationChain 或 memory 实例,例如用一个字典来存储
from langchain.memory import ConversationBufferMemory
from langchain.chains import ConversationChain
from util_ali_llm import QwenLLM

# 初始化 LLM
api_key = "sk-30a***123"
qwen_llm = QwenLLM(api_key=api_key)

# 模拟用户会话池
user_sessions = {}

def get_user_chain(user_id):
    if user_id not in user_sessions:
        memory = ConversationBufferMemory()
        chain = ConversationChain(llm=qwen_llm, memory=memory)
        user_sessions[user_id] = chain
    return user_sessions[user_id]

user_id = "user_001"
chain = get_user_chain(user_id)

print(chain.run("请翻译:有勇气的牛排"))
print(chain.run("今天天气如何"))
print(chain.run("十二生肖有哪些"))
print(chain.run("我刚刚说了什么?"))

print(user_sessions)
6.2 方法二:使用「向量记忆 + 用户ID过滤」
方案(用于长期存储)
7. VectorStore 模块(文档问答)
文档向量化后可用于语义检索。
加载文本 + FAISS 构建知识库 + 问答
from langchain.vectorstores import FAISS
from langchain.embeddings import HuggingFaceEmbeddings
from langchain.text_splitter import CharacterTextSplitter
from langchain.document_loaders import TextLoader
from langchain.chains import RetrievalQA

# 文本加载
loader = TextLoader("阿里介绍.txt", encoding="utf-8")
docs = loader.load()

# 分词
text_splitter = CharacterTextSplitter(chunk_size=500, chunk_overlap=100)
split_docs = text_splitter.split_documents(docs)

# 嵌入模型
embedding = HuggingFaceEmbeddings(model_name="shibing624/text2vec-base-chinese")
db = FAISS.from_documents(split_docs, embedding)

# 构建问答链
retriever = db.as_retriever()
qa = RetrievalQA.from_chain_type(llm=llm, retriever=retriever)

print(qa.run("阿里的主营业务是什么?"))
8 总结
| 模块 | 案例 | 用途 |
|---|---|---|
| LLM | 接入通义千问 | 语言模型问答 |
| Prompt | 自定义提示词 | 控制输出风格 |
| Chain | LLM链 | 串联多个组件处理逻辑 |
| Tool | 阿里天气 | 对外接口封装 |
| Agent | 自主调用工具 | 构建多工具智能体 |
| Memory | 聊天记忆 | 上下文连续对话 |
| VectorDB | 阿里介绍文档 | 文档问答、企业知识库系统 |
标签: