LangChain 文档加载教程(TXT|WORD|PDF|Markdown)
知止自律打卡-微信小程序APP
一款微信自律打卡小程序,支持自定义打卡项目、习惯记录、项目日记、专注计时与数据统计。自律打卡、学习打卡、读书打卡、健身打卡、运动打卡、减肥打卡、戒色打卡、养生打卡、戒烟、戒酒、戒熬夜等多种场景。万能打卡模板自由创建。可自定义每日打卡目标,记录习惯连续天数,可视化追踪成长进度。
了解产品详情 →
微信搜索「知止自律打卡」
1 前言
1.1 定义
在 LangChain 中,文档加载器(Document Loaders) 用于将各种文件格式(如 txt、PDF 等)读取并转换为统一的数据结构 Document,便于后续进行向量化、问答、摘要等操作。
1.2 Document 对象结构说明
LangChain 中加载的每一份文档都会被转换为一个或多个 Document 对象,其结构如下:
Document(
    page_content="文档的主要文本内容",
    metadata={"source": "文件路径", "page": 页码(如果有)}
)
page_content:文档主体内容(字符串)metadata:文档元数据,如文件名、页码、来源路径等
1.3 环境安装
python3.10
langchain-community==0.3.27
3 场景案例
3.1 加载 TXT 文本文件
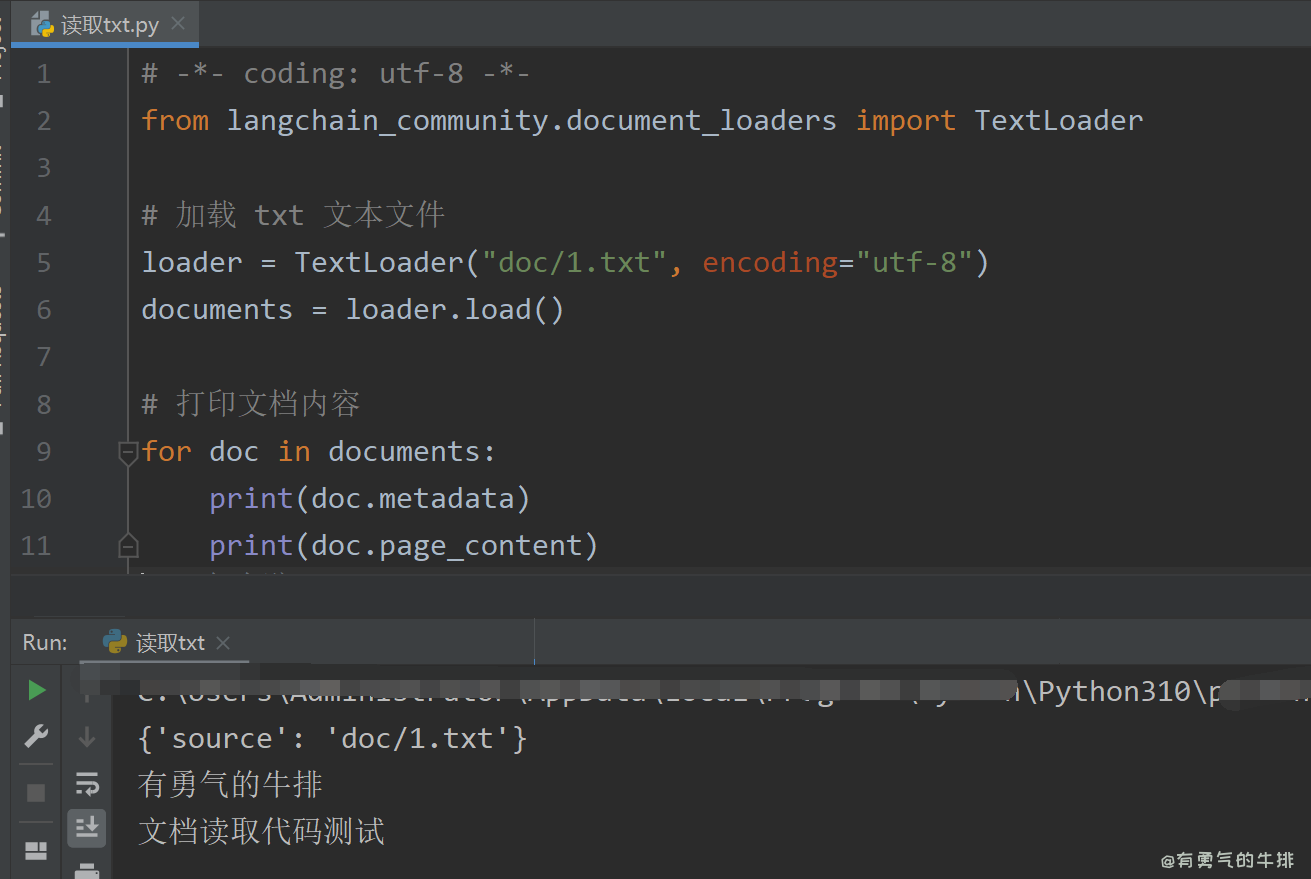
使用 TextLoader 加载纯文本文件
# -*- coding: utf-8 -*-
from langchain_community.document_loaders import TextLoader

# 1. 创建 TXT 加载器实例
loader = TextLoader("doc/1.txt", encoding="utf-8")

# 2. 加载文档,返回的是一个 Document 列表
documents = loader.load()

# 3. 遍历输出每个文档的内容和元信息
for doc in documents:
    print(doc.metadata)       # 输出元数据,如文件路径
    print(doc.page_content)   # 输出正文内容
3.2 加载 PDF 文件
使用 PyPDFLoader 加载 PDF 文件
from langchain_community.document_loaders import PyPDFLoader

# 1. 创建 PDF 加载器实例
loader = PyPDFLoader("doc/红楼梦.pdf")

# 2. 加载并自动按页拆分成多个 Document 实例
pages = loader.load_and_split()

# 3. 输出前5页内容预览
for i, page in enumerate(pages[:5]):
    print(f"第 {i+1} 页内容:")
    print(page.page_content[:300])  # 每页仅显示前300字符
    print("-" * 60)
说明:
load_and_split()会将 PDF 拆分为按页组织的多个Document- 每页成为一个独立
Document,保留页码信息metadata['page'] - 特别适合后续 向量化检索 或 逐页问答分析
3.3 加载word
pip install "unstructured[all-docs]"
unstructured==0.18.9
python-docx==1.2.0
from langchain_community.document_loaders import UnstructuredWordDocumentLoader

# 加载 Word 文档(.docx)
loader = UnstructuredWordDocumentLoader("doc/cs.docx")
documents = loader.load()

# 打印内容
for doc in documents:
    print(doc.metadata)
    print(doc.page_content[:300])  # 输出前300字符
支持ORC
pip install "unstructured[all-docs,local-inference]" pytesseract pillow python-docx
unstructured==0.18.9
python-docx==1.2.0
3.4 加载 Markdown 文档
使用 UnstructuredMarkdownLoader
from langchain_community.document_loaders import UnstructuredMarkdownLoader

# 加载 Markdown 文件
loader = UnstructuredMarkdownLoader("./LangChain教程.md")
documents = loader.load()

# 打印 Markdown 正文内容
for doc in documents:
    print(doc.metadata)
    print(doc.page_content[:300])
4 应用场景
无论是 TXT 还是 PDF 加载后得到的 Document 对象,都可以用于以下 LangChain 应用:
- 🔍 向量数据库存储(如 FAISS)
- ❓ 基于文档的问答(Retrieval QA)
- 📝 文本摘要、翻译、分类等任务
- 🔄 多语言处理或批量预处理
5 其他
OCR项目
https://github.com/tesseract-ocr/tesseract
标签: