Python 数据类型 列表 常见问答
知止自律打卡-微信小程序APP
一款微信自律打卡小程序,支持自定义打卡项目、习惯记录、项目日记、专注计时与数据统计。自律打卡、学习打卡、读书打卡、健身打卡、运动打卡、减肥打卡、戒色打卡、养生打卡、戒烟、戒酒、戒熬夜等多种场景。万能打卡模板自由创建。可自定义每日打卡目标,记录习惯连续天数,可视化追踪成长进度。
了解产品详情 →
微信搜索「知止自律打卡」
Python 数据类型 列表 常见问答
复杂度举例
for i in list_a O(n)
每次循环 i 会从 列表中去除一个元素,即复杂度为O(n)。
list_a = [1, 2, 3]  # 长度 n=3

for i in list_a:
    # 每循环一次为O(1)
if i in list_a O(n)
list_a = [1, 2, 3, 4, 5]

x = 5
if x in list_a:
   print("okk")
如果 x=1,只需要比较1次。
如果 x=5,需要比较5次。
如果 x=100,需要比较完整列表,仍然找不到哦。
所以在最坏情况下,需要比较n此,故时间复杂度为O(n)。
列表去重
set方法
原理:将列表转为 set 集合(自动去重),然后在转为list。
输出不能保证顺序,因为 set 是无序集合。
num_list = [1, 2, 3, 2, 1]
print(list(set(num_list)))
使用循环 + in 判断
num_list = [1, 2, 3, 2, 1]

unique_list = []
for i in num_list:
    if i not in unique_list:
        unique_list.append(i)
print(unique_list)
使用 dict.fromkeys()
在python3.6开始,此方法有序。
# -*- coding: utf-8 -*-
num_list = [1, 2, 3, 2, 1]

print(dict.fromkeys(num_list))  # {1: None, 2: None, 3: None}
print(list(dict.fromkeys(num_list))) # [1, 2, 3]
字符串切割为列表
将 "1,2,3" 转 ["1","2","3"]
s = "1,2,3"
print(s.split(","))
# 输出:['1', '2', '3']
给定2个 list,A和B,找出相同元素和不同元素
方法一:使用循环(列表推导式)
list_a = [1, 2, 3, 3, 4, 5, 6]
list_b = [1, 3, 5]
same_list = [i for i in list_a if i in list_b]
diff_list = [i for i in list_a if i not in list_b]

print(same_list)
print(diff_list)
✔优点:
- 保持元素顺序:
same_list和diff_list中的元素保持了第一个列表的顺序。 - 可处理重复元素(不丢失):如果
list_a或list_b中有重复元素,会保留它们,适合对重复敏感的场景。
❌ 缺点:
-
效率低下:
for i in list_a的复杂度为 O(n),整体复杂度如下:same_list: O(m*n) diff_list: O(m*n)其中
m = len(list_a),n = len(list_b)。
方法二:使用集合运算(set 与、或、异或)
# -*- coding: utf-8 -*-
list_a = [1, 2, 3, 4, 5, 6]
list_b = [1, 3, 5]
same_list = list(set(list_a) & set(list_b)) # 交集
diff_list = list(set(list_a) ^ set(list_b)) # 对称差集

print(same_list)  # 输出:[1, 3, 5]
print(diff_list)  # 输出:[2, 4, 6]
整体复杂度:
O(m + n)
✔优点:
- 效率高:集合操作是基于哈希表,查找和交并差操作平均复杂度为 O(1)。
- 代码简洁直观:使用集合操作可以一行搞定交集、差集、并集等。
❌ 缺点:
- 去重:集合会自动去重,丢失重复元素信息。
- 顺序丢失:集合是无需结构,输出结果顺序肯呢个与原始列表不同。
- 只适用于可哈希类型。
保留顺序又提高性能
set_b = set(list_b)
same_list = [i for i in list_a if i in set_b]
diff_list = [i for i in list_a if i not in set_b]
这样可以将 in list_b 的O(n)降为 O(1)。
建议
方法一:数据量小、需要保留顺序、重复值。
方法二:数据量大、对性能敏感、重复性不重要。
方法三:保留一个的顺序,部分提高性能。
展开该列表 [[1,2],[3,4],[5,6]]为单列表
用一行代码展开该列表 [[1,2],[3,4],[5,6]],得出[1,2,3,4,5,6]
mm = [[1, 2], [3, 4], [5, 6]]
print([j for i in mm for j in i])
合并列表
使用加号 +(返回新列表)
a = [1, 3, 5]
b = [2, 4, 6]
print(a+b)
a = [1, 3, 5]
b = [2, 4, 6]
a += b
print(a)
extend(就地修改)
a = [1, 3, 5]
b = [2, 4, 6]

a.extend(b)
print(a)
使用*unpacking (推荐灵活)
# -*- coding: utf-8 -*-
a = [1, 3, 5]
b = [2, 4, 6]

c = [*a, *b]
print(c)
使用 itertools.chain() (生成器,内存友好)
合并大数据时更高效,适合性能要求高的场景。
# -*- coding: utf-8 -*-
from itertools import chain

a = [1, 3, 5]
b = [2, 4, 6]
c = [7, 8, 9]

d = list(chain(a, b, c))
print(d)
列表 打乱顺序/随机排序
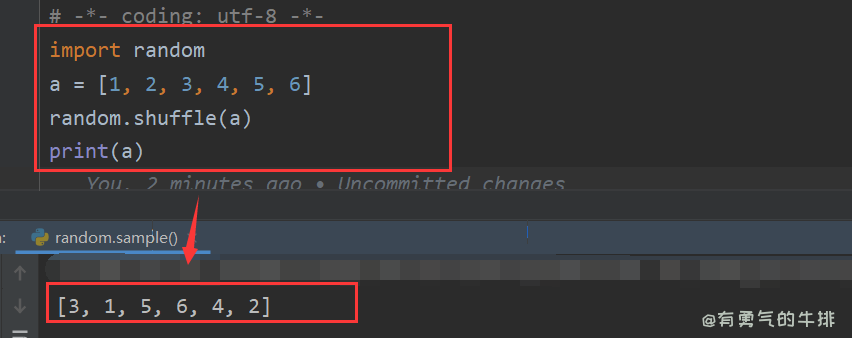
radom.shuffle() 就地修改
特点:
- 原地修改(不返回新列表)
- 返回值为 None
- 会改变原始列表内容
# -*- coding: utf-8 -*-
import random
a = [1, 2, 3, 4, 5, 6]
random.shuffle(a)
print(a)
radom.sample() 返回新列表
特点:
- 不会修改原始列表
- 返回一个新的乱序副本
- k 是指定要返回多少个元素
# -*- coding: utf-8 -*-
import random
a = [1, 2, 3, 4, 5, 6]

shuffled = random.sample(a, k=len(a))
print(shuffled)
标签: